zkVMのリアルタイム証明は使えるか|平均ではなく締切で測る性能比較と採用判断
約13分で読めます
約13分
目次(タップで折りたたみ)
あるチームが、12秒ごとに進むプロトコルの経路に、zkVMで作った証明を組み込もうとしています。試しに測ると、証明にかかる時間は平均10秒でした。締切の12秒には収まっているように見えます。
ところが、一部のブロックでは40秒かかっていました。平均が10秒でも、ときどき40秒かかるなら、12秒で回る経路にはそのまま使えません。その回の証明が、締切に間に合わないからです。
zkVMの証明をリアルタイムの処理に使えるかどうかは、平均の速さではなく、その業務の締切に毎回間に合うかで決まります。ですから、平均の証明時間だけでは判断できません。次のことを、同じ条件で測ります。
- 入力を取ってきてから検証が終わるまでの時間と、そのばらつき
- 止まらずに処理し続けられる量と、メモリの使用量
- 障害が起きたときのやり直し
このチームは、L2や自社チェーン、検証可能計算を設計しています。以下では、チームがzkVM(zero-knowledge virtual machine)の処理を段階に分けて測り、再現できるベンチマークと運用の目標値(SLO)にするまでを追います。
この記事でわかること
- 「リアルタイム」を締切から決める方法と、締切の内訳
- 公称の速さに頼らず、条件をそろえて比べる方法と、負荷試験の手順
- 分散証明の故障、締切を超えたときの代わりの道、採用してよいかの6つの判定
この記事で使う言葉
- witness:証明を作る材料になる中間データ
- STARK/SNARK:証明方式の種類。STARKは証明が大きくなりやすく、SNARKは小さくチェーン上で検証しやすい
- wrapper:できた証明を、チェーン上で検証しやすい形に包み直す処理
- precompile:hashや署名検証など、よく使う処理を速くするための専用回路
- p95/p99:95%・99%の処理が収まる時間
「リアルタイム」は、何の締切に間に合うことか
リアルタイムは、製品の名前でも、決まった秒数でもありません。証明が使われる前に間に合うことです。
Ethereum L1のブロックの証明なら、12秒のスロットが基準になります。Ethereum Foundationも、リアルタイム証明を「12秒のスロットの中でブロックの証明を作ること」と説明しています。一方、L2のバッチ、ブリッジの出金、コプロセッサーのAPIでは、締切が違います(ethereum.org「L1ブロック検証のためのzkEVM」)。
そこで最初に、締切の中で時間をどう配るか(締切の内訳)を書き出します。
proof_deadline
  > input_fetch
  + witness_and_trace
  + core_proving
  + recursion_or_wrapper
  + verification
  + submission
  + retry_margin
それぞれの意味は次のとおりです。
input_fetch:入力のデータを取ってくる時間witness_and_trace:witnessと実行トレース(後述)を作る時間core_proving:中心となる証明を作る時間recursion_or_wrapper:証明をまとめる(再帰)か、wrapperで包み直す時間verification・submission:検証する時間と、証明を送る時間retry_margin:やり直しのための余裕
冒頭の40秒のように、ときどき大きく遅れる回があります。ですから、測った値が締切を一度下回っただけでは足りません。次の4つを分けて測ります。ふだんの負荷でのp95。高い負荷と最大の入力でのp99。続けて動かしたときの待ち行列での待ち時間。証明を作るワーカーが故障した後のやり直しです。
実行トレース、証明、検証に分けると、どこが遅いかが見える
まず、zkVMの中で何が起きているかを見ておきます。
zkVMは、証明したいプログラム(guest program)を命令の列として実行します。そのとき、各ステップのレジスタ、メモリ、入出力などを、実行トレース(execution trace)に記録します。証明者(prover)は、「このトレースがVMの制約を満たし、公開入力から公開出力へ正しく移った」ことを示す証明を作ります。検証者(verifier)はプログラムを実行し直さず、検証鍵、公開入出力、証明のつじつまを確かめます。
RISC Zeroの仕様も、計算が正しいことを「実行トレースが制約を満たす」という主張として組み立てています(RISC Zero zkVM: Scalable, Transparent Arguments)。
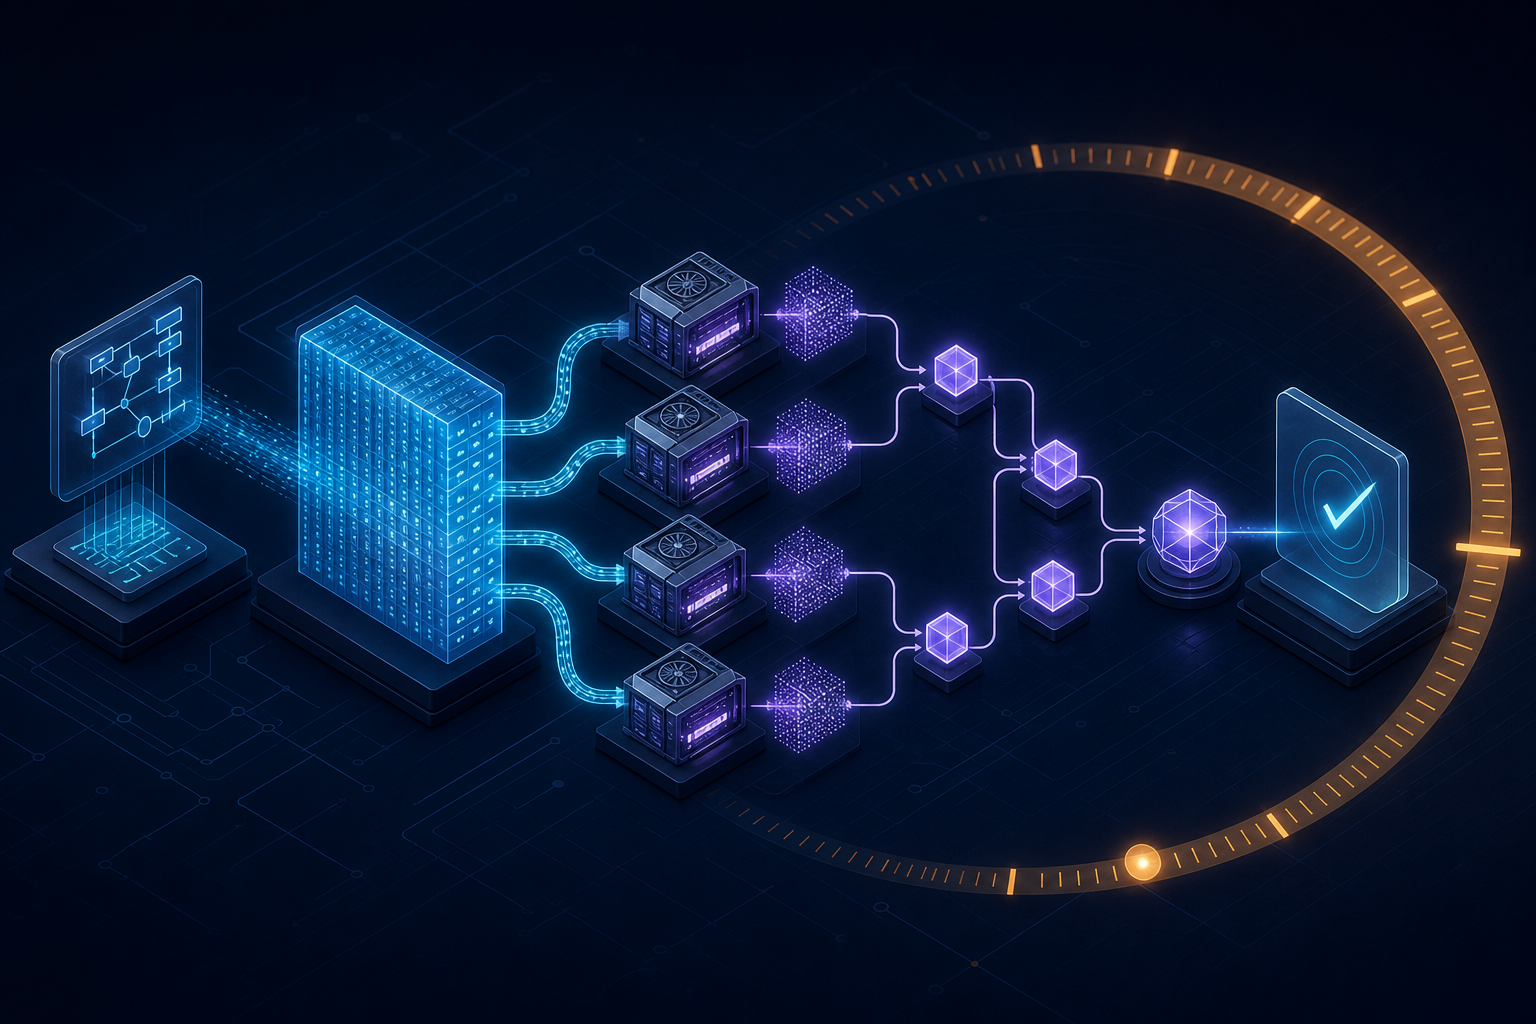
このように段階が分かれているので、速くする工夫も、段階ごとに効き方が違います。たとえば、guestの中のhashや署名検証をprecompileに置き換えると、実行の手数(サイクル数)は減ります。ところが、入力の取得やトレースの生成に時間の大半がかかっているなら、GPUを増やしても、端から端までの遅れは縮みません。
Zirenの公式のアーキテクチャも、段階を別々の部品として説明しています。実行の分割(shard)、各shardのSTARK証明、集約、STARKからSNARKへの変換です(Ziren Prover Architecture)。zkVMを比べるときも、この段階の区切りをそろえる必要があります。
公称の速さではなく、測った条件をそろえて比べる
条件をそろえずに数字を並べると、次のような取り違えが起きます。
- Fibonacciのような小さなプログラムと、実際のブロックを、同じ速さの指標で比べてしまう
- 中心の証明の時間だけを、利用者が感じる遅れだと思ってしまう
- 大きいSTARKと、チェーン上で使うSNARKを同じ列に並べてしまう
- GPU1台の結果とクラスターの結果の差を、製品の差だと思ってしまう
- バージョンの更新や、専用の最適化による差を見落とす
- いちばん良かった値や平均だけで、目標値を決めてしまう
ですから、比べるときは次の条件を固定し、記録しておきます。
| 条件 | 固定・記録する値 |
|---|---|
| 負荷の中身 | プログラムのcommit、コンパイラ、入力の集合、最大入力、公開/非公開の入出力 |
| 計測の境界 | データ取得、witness、トレース、中核の証明、再帰、wrapper、アップロード |
| 証明 | 証明方式、安全性のビット数、圧縮/再帰の有無、最終wrapper |
| ハードウェア | CPU/GPUの型番、台数、RAM/VRAM(主記憶/GPUのメモリ)、ネットワーク、ストレージ、リージョン |
| ソフトウェア | zkVMのバージョン/commit、guestの命令セット、有効な機能、precompile、証明者の設定 |
| 統計 | ウォームアップ、試行数、p50/p95/p99、失敗率、最大メモリ使用量(RSS)、測定時刻 |
表の上から順に、先ほどの6つの取り違えに対応しています。
Ethereum Foundationのベンチマークの方針も同じ考えです。おもちゃのプログラムではなく、実際の実行ソフトウェア(execution client)とブロックを使い、最悪の場合を評価する必要があるとしています(Benchmarking zkVMs for Ethereum)。
数字の範囲にも注意が要ります。EthproofsのAPIでは、proving timeにwitnessの生成を含める一方、データの取得と証明の送信にかかる遅れは除いています(Ethproofs API)。同じ「proving time」という名前でも、自社の目標値が数える範囲と同じとは限りません。
公称の値は、見当を付けるのには使えます。SuccinctはSP1 Hypercubeについて、2025年5月の最初の発表で、次のように報告しました。Merkle証明の取得を除いて、Ethereumメインネットのブロックの93%を12秒未満、平均10.3秒で証明した(SP1 Hypercube benchmark)。
その後、2025年11月18日には、16台のNVIDIA RTX 5090で954ブロックを証明したと報告しています。99.7%を12秒未満、95.4%を10秒未満で証明したという内容です(SP1 Hypercube Achieves Real Time Proving with 16 GPUs)。
ただし、どちらも公開された条件での、ベンダー自身による測定です。別の負荷や、端から端までの目標値を保証するものではありません。
遅れと処理できる量は、別々に負荷試験する
1つの証明が締切に間に合っていても、証明の依頼が届く速さが、処理する速さを上回れば、待ち行列は伸び続けます。そのため、1回ごとの遅れとは別に、続けて処理できる量も確かめます。
ブロックあたりのガスをG、証明にかけてよい時間をD秒とすると、必要な最低の処理能力はおおよそ G / D です。Ethereum Foundationの例では、ガス上限60Mを8秒で証明するには、7.5 Mgas/sが必要です(Repricings for block proving, Part 2)。
ただし、同じガス量でも、使われる命令(opcode)の組み合わせによって証明の負荷は変わります。ですから、実際のブロックの集合で確かめます。手順は次の5つです。
- 入力の集合を固める:ふだんの入力、計算の多い入力、メモリを多く使う入力、precompileを多く使う入力、最大の入力、知られている攻撃的な入力を保存する。
- 1回ごとの遅れを測る:起動直後(cold)と温まった状態(warm)を分け、段階ごとのp50/p95/p99と、最大のRSS/VRAMを測る。
- 続けて流す:実際に届く速さ以上で数時間流し、待ち行列の深さ、ディスクへのあふれ(spill)、ネットワーク、熱による性能の低下、証明の失敗率を測る。
- わざと障害を起こす:ワーカーの強制停止、GPUのエラー、オブジェクトストレージの遅れ、重複したジョブ、shardの抜けを起こし、やり直しと冪等性(同じ処理を何度しても結果が1回分になること)を確かめる。
- 検証を測る:証明のサイズ、検証の時間、チェーン上のガス、公開入力のサイズ、不正な証明を断れるかを測る。
結果は、「いちばん速いzkVM」を決める表にはしません。負荷の種類ごとに、目標値を満たすかどうかを示す表にします。
費用も、ハードウェアの単価だけでは測れません。いつも確保しておく予備の処理能力、失敗とやり直し、外への転送量、外部の証明ネットワークの手数料がかかるからです。これらを含めて、次の2つを記録します。
- 採用された証明1件あたりの費用(
cost per accepted proof) - 証明した処理量あたりの費用(
cost per proven unit)
証明を分散すると、速くなる代わりに新しい故障が増える
トレースをshardに分けると、中心の証明は並列にできます。ところが、分ける前のトレースの生成、shardの配送、いちばん遅いワーカー、証明の集約は、順番に進むか、全部そろうまで待つ区間になります。そのため、必要なワーカーの数を平均で決めると、1台が遅れただけで全体が締切を超えます。
故障の形ごとに、見つけ方と安全な止め方を決めておきます。
| 障害 | 見つけ方 | 安全な対応 |
|---|---|---|
| ワーカーの停止・極端に遅いワーカー(straggler) | shardごとの締切、死活監視(heartbeat)、進み具合 | 同じジョブIDで別のワーカーへ割り当て直す。二重にできた結果はcommitmentで重複を除く |
| 入力・バージョンの不一致 | プログラムID、入力のhash、証明者のバージョン | ジョブの記録(manifest)が合わなければ、実行の前に断る |
| 証明の不正・破損 | shardの証明と、集約した後の証明を別々に検証 | 検証の前に次の工程へ渡さず、そのワーカーを切り離す |
| メモリ超過 | RSS/VRAM、ディスクへのあふれ、OOM(メモリ不足での強制終了)のイベント | shardを小さくする、受け入れる量を絞る(admission control)、別のワーカー群へ振り分ける |
| 未処理の積み上がり(backlog) | 待ち行列の経過時間、届く速さ/処理する速さ、締切超過の予測 | 優先度の低い処理を抑え、バッチを小さくするか、代わりの道へ移る |
外部の証明ネットワークを使う場合は、別に確かめることがあります。秘密の入力を誰が取れるか、暗号化と削除、リージョン、止まりにくさ、バージョンの固定、証明を検証する責任です。ゼロ知識証明を作ってもらうとき、証明者には入力を渡すことになります。ですから、「ゼロ知識証明を作る」ことと、「証明者に入力を隠せる」ことは同じではありません。
締切を超えたときの代わりの道を、プロトコルに組み込む
リアルタイムの経路を必須にすると、証明者が止まったとき、それがそのままチェーンの停止や出金の停止につながります。ですから設計の段階で、締切を超えることを、安全に移れる状態の1つとして扱います。
- L2:バッチのサイズやブロックのガスを一時的に小さくし、証明の積み上がりに応じてシーケンサー(取引の順番を決める役)の受け入れ量を絞る。
- ブリッジ:まだ証明されていない状態を確定扱いせず、出金を保留のままにする。別の証明方式に切り替えるなら、安全性の前提が変わることをはっきり示す。
- API型の検証可能計算:同期の応答を「証明待ち」で止めない。ジョブIDと未確定の状態を返し、検証が済んだ結果だけを確定とする。
- 共通:同じ入力を重ねて実行しても1つだけ採用できる冪等性キー、証明・プログラム・入力の結び付け、再開のときの積み上がりの上限を持つ。
代わりの道の保証が、ふだんの道より弱いこともあります。その場合は、自動で切り替えるだけでは済ませません。利用者・バリデーター・ブリッジのコントラクトが、どの状態を確定とみなすかを仕様に書き、見張る権限と解除する権限を分けます。
採用してよいかを、6つの点で判定する
PoCでいちばん速かった値ではなく、運用に余裕があるかで判定します。
1つでも満たせない場合は、リアルタイムの経路への採用を保留します。そのうえで、次を考えます。
- 非同期の証明で足りないか:非同期の証明で要件を満たせるなら、複雑な分散証明の仕組みを先に入れないほうが、止まりにくさと費用を管理しやすい場合があります。
- VMの選び方を見直す:言語が合うかや最速の値だけでなく、再現できるベンチマーク、監査できる証明方式、アップグレードの手順、運用の道具も含めて判断します。
ZKを金融取引の秘匿に使う場合は、オンチェーン金融のプライバシー設計も参照してください。
XTELAができること
XTELAは、検証可能計算やブロックチェーンのシステムについて、要件の整理、ベンチマークの仕組みづくり、PoC、証明の待ち行列・監視・代替経路を含む設計と開発を行います。特定のzkVMを先に決めるのではなく、貴社の負荷と締切で測った結果から採否を判断できるようにします。既存システムとの接続まで検証したい場合は、XTELAへご相談ください。
主要参考資料
- ethereum.org: L1ブロック検証のためのzkEVM
- Ethereum Foundation: Benchmarking zkVMs for Ethereum
- Ethereum Foundation: Repricings for block proving, Part 2(2026年9月24日確認)
- Ethproofs: Learn & resources
- Ethproofs API(2026年9月24日確認)
- Succinct: SP1 Hypercube benchmark(2025年5月の初回発表)
- Succinct: SP1 Hypercube Achieves Real Time Proving with 16 GPUs(2025年11月18日、2026年9月24日確認)
- RISC Zero zkVM: Scalable, Transparent Arguments
- Ziren Prover Architecture
資料の確認日と注意
SP1 Hypercube、Ethproofs API、Ethereum Foundationの処理能力の目標は、2026年9月24日に確認し直しました。そのほかの資料は2026年8月12日に確認しています。zkVM、ベンチマーク、ネットワークの仕様は更新されるため、採用するときは、使うバージョンの仕様と、自社での測定で確かめてください。
