Hyperliquidのデータ取得|HyperCore API・WebSocket・S3のasset_ctxs・RPCの使い分け
約17分で読めます
約17分
目次(タップで折りたたみ)
Hyperliquid の仕様・制限は変更される可能性があるため、実装前に公式ドキュメントを確認してください。
Hyperliquid を事業やプロダクトに組み込むとき、最初に整理すべきなのは「どの API を使うか」ではなく、何のために Hyperliquid のデータや実行環境へ接続するのかである。
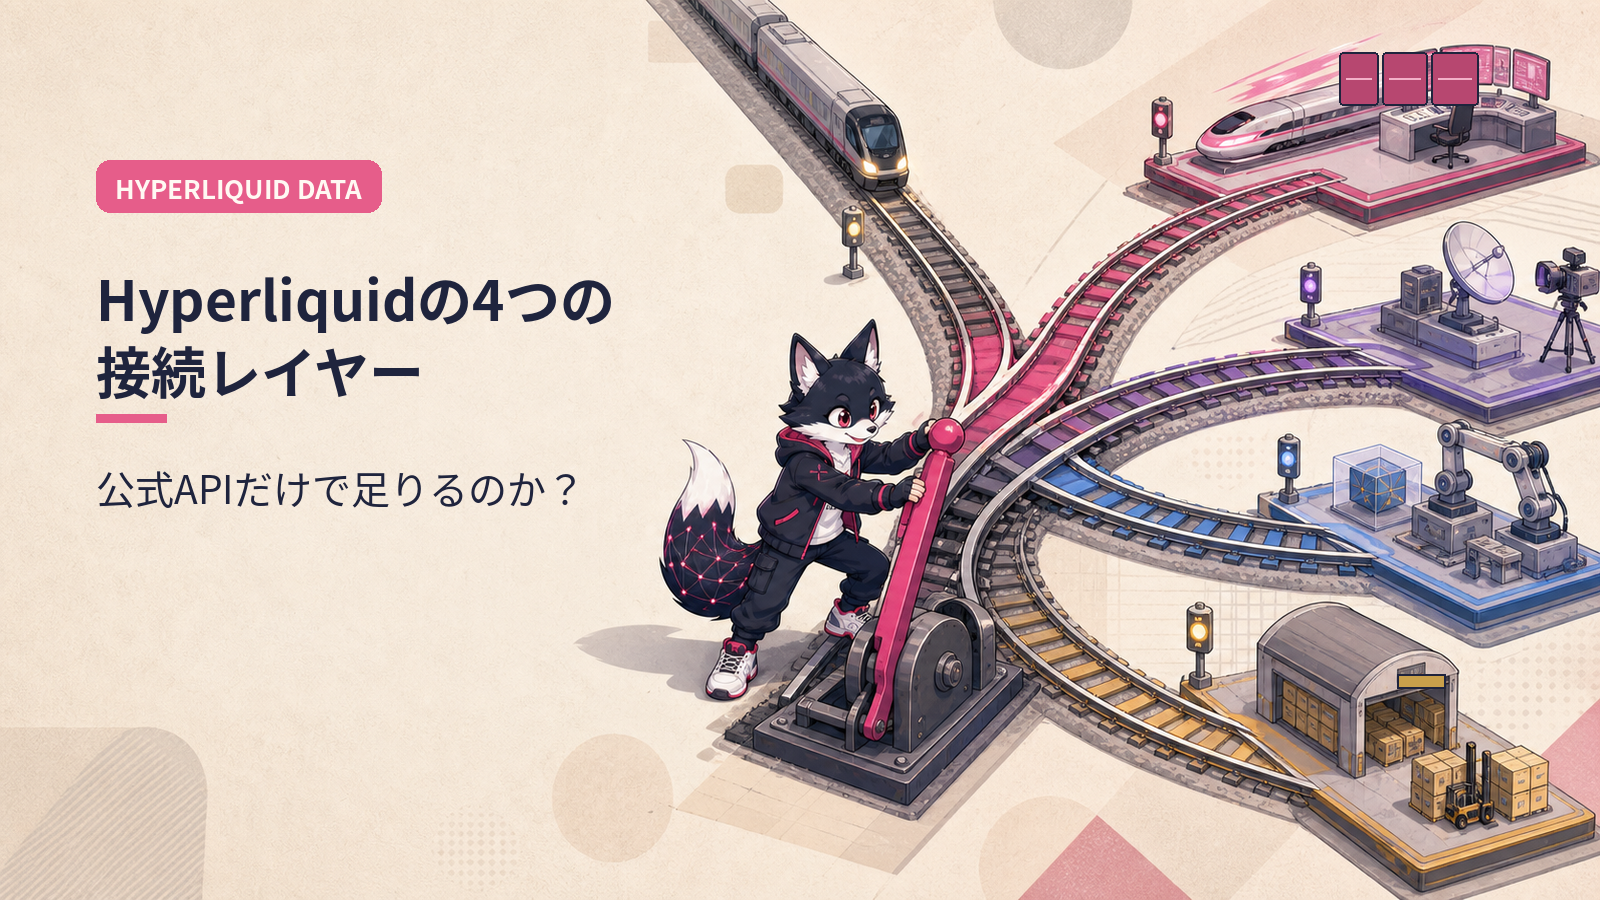
同じ「Hyperliquid API」でも、実際には少なくとも4つのレイヤーがある。
- HyperCore API: 注文、約定、板、ポジション、ユーザー状態など、取引所本体に関わる API
- WebSocket: リアルタイムの板・約定・ユーザーイベントを購読するストリーム
- HyperEVM JSON-RPC: Hyperliquid 上の EVM 互換スマートコントラクトに接続する RPC
- 履歴データ基盤: 公式 S3、独自収集、第三者データプロバイダーを組み合わせる分析・監査用基盤
取引アプリを作るのか、分析ダッシュボードを作るのか、マーケットメイクをするのか、機関顧客向けに執行・レポーティングを提供するのかで、必要な構成は大きく変わる。本記事では、Hyperliquid の API・RPC・データ基盤を事業者目線で分解し、どこまで公式 API で足り、どこから自前または外部プロバイダーが必要になるかを整理する。
目次
- なぜ事業者が Hyperliquid インフラを理解する必要があるのか
- HyperCore と HyperEVM の違い
- 公式 API で取れるデータと実行できる操作
- WebSocket を使うべき場面
- HyperEVM JSON-RPC の使いどころと制約
- 履歴データは公式 S3 だけで足りるか
- 用途別の推奨アーキテクチャ
- 外部 RPC・データプロバイダーを使う判断軸
- 実装時のリスクとチェックリスト
- まとめ
1. なぜ事業者が Hyperliquid インフラを理解する必要があるのか
Hyperliquid は単なる DEX ではなく、独自 L1、オンチェーン orderbook、Perps 取引、HyperEVM を含む複合的な取引インフラである。ユーザーとして画面から売買するだけなら細部を知らなくてもよいが、事業者が上にプロダクトを作る場合は話が変わる。
典型的なユースケースは次の通り。
- 取引アプリ / 執行フロントエンド: 注文送信、約定確認、ポジション表示、リスク管理が必要
- 分析ダッシュボード: 板、約定、建玉、funding、ユーザー行動、銘柄別データを継続取得する必要
- マーケットメイク / 裁定ボット: 低レイテンシの板更新、安定した WebSocket、注文キャンセル、障害時の再接続が重要
- 機関向け接続: 監査ログ、履歴データ、レポート生成、運用権限分離、フェイルオーバーが重要
- HyperEVM dApp: EVM JSON-RPC、イベントログ、コントラクト状態、HyperCore との連携理解が必要
ここで重要なのは、「Hyperliquid を使う」ことと「Hyperliquid をプロダクトに組み込む」ことは別物だという点である。
前者は取引 UX の問題。後者は、API 制限、データ欠損、再接続、署名、秘密鍵管理、履歴再構築、レイテンシ、監査可能性まで含むインフラ設計の問題になる。
2. HyperCore と HyperEVM の違い
Hyperliquid の接続設計で最初につまずきやすいのが、HyperCore と HyperEVM の違いである。
HyperCore
HyperCore は、Hyperliquid の取引所機能そのものを担うレイヤーである。Perps、スポット、注文、板、約定、ポジション、清算、funding など、トレーディングに関わる中核データは HyperCore 側にある。
開発者が主に使うのは次の API である。
-
https://api.hyperliquid.xyz/info -
https://api.hyperliquid.xyz/exchange -
wss://api.hyperliquid.xyz/ws
info endpoint は取引所やユーザーの状態を取得するための入口であり、公式 Docs では「exchange and specific users」に関する情報を取得する endpoint と説明されている。時間範囲を指定するレスポンスには件数制限があり、より広い範囲を取得する場合は最後に返った timestamp を次の startTime として使うページネーションが必要になる(出典: Hyperliquid Docs - Info endpoint)。
exchange endpoint は注文送信やキャンセルなど、Hyperliquid chain への取引操作に使う。公式 Docs も、この endpoint を「interact with and trade on the Hyperliquid chain」するためのものとしている(出典: Hyperliquid Docs - Exchange endpoint)。
HyperEVM
HyperEVM は、Hyperliquid の実行環境内にある EVM 互換レイヤーである。スマートコントラクトをデプロイしたり、EVM dApp を移植したりする場合はこちらを使う。
公式 Docs では、HyperEVM は Hyperliquid の実行の一部として作られる EVM block であり、HyperBFT consensus のセキュリティを継承すると説明されている。mainnet の chain ID は 999、JSON-RPC endpoint は https://rpc.hyperliquid.xyz/evm である(出典: Hyperliquid Docs - HyperEVM)。
ただし、HyperEVM RPC は「Ethereum 互換だから何でも Ethereum と同じ」と考えると危ない。公式の JSON-RPC ページでは、eth_call や eth_getBalance など一部メソッドについて latest block のみ対応、eth_getLogs は query range が最大 50 blocks、default RPC では historical state を要求する request は未対応といった制約が示されている(出典: Hyperliquid Docs - JSON-RPC)。
実務上の読み分け
| やりたいこと | 主に見るレイヤー | 理由 |
|---|---|---|
| Perps の板・約定・ポジションを表示する | HyperCore API / WebSocket | 取引所本体の状態は HyperCore 側にある |
| 注文を送る / キャンセルする | HyperCore exchange endpoint | 取引操作は署名付き action として送る |
| HyperEVM 上のコントラクトを読む | HyperEVM JSON-RPC | EVM 状態は JSON-RPC で読む |
| HyperEVM dApp のイベントを追う | HyperEVM JSON-RPC + 独自 indexer | default RPC の履歴・ログ制約を考慮する |
| 長期の板・約定分析をする | 公式 S3 + API 収集 + 独自 DB | API だけで長期履歴を都度引く設計は弱い |
3. 公式 API で取れるデータと実行できる操作
HyperCore 側の公式 API は、大きく 読み取り系の info と 書き込み系の exchange に分かれる。
info endpoint
info は取引所状態、ユーザー状態、市場データを読むための endpoint である。
代表的な用途:
- 全銘柄の mid price 取得
- open orders の取得
- user fills / user fills by time の取得
- order status の確認
- L2 book snapshot の取得
- candle snapshot の取得
- user rate limit の確認
注意すべき制約もある。公式 Docs では、時間範囲を取るレスポンスは 500 件または distinct blocks まで、userFillsByTime は1レスポンス最大 2,000 fills で、参照できるのは直近 10,000 fills までと説明されている。また candle snapshot は直近 5,000 candles のみである(出典: Hyperliquid Docs - Info endpoint)。
このため、長期履歴分析や監査レポートを info endpoint だけで後から再構築する設計は避けたい。必要なデータはリアルタイムに収集して自社 DB に蓄積するか、公式 S3 や第三者データ基盤と組み合わせるべきである。
exchange endpoint
exchange は注文、キャンセル、送金、vault 関連操作など、状態を変える操作に使う。
実装上の注意点:
- 署名処理が必要
- nonce 管理が必要
- subaccount / vault は秘密鍵を持たないため、master account による署名と
vaultAddressの指定が必要 - 一部 action は
expiresAfterを持てるが、期限切れで cancel されると通常より重い address-based rate limit を消費する - client order id (
cloid) を使うと、注文状態追跡と再送制御がしやすい
取引系プロダクトでは、API 呼び出しそのものよりも 状態管理 が難しい。注文を送った、WebSocket が切れた、再接続した、直前の約定が反映されていない、という状況で、同じ注文を二重送信しない設計が必要になる。
4. WebSocket を使うべき場面
WebSocket は、リアルタイムデータを扱うプロダクトではほぼ必須である。
公式 Docs では mainnet の WebSocket URL は wss://api.hyperliquid.xyz/ws、testnet は wss://api.hyperliquid-testnet.xyz/ws とされている。リアルタイムデータストリーミングだけでなく、HTTP request sending の代替としても使える(出典: Hyperliquid Docs - Websocket)。
WebSocket が向く用途
- 板更新をリアルタイムに表示する
- 約定履歴をストリームで受ける
- ユーザーの注文・約定・ポジション変化を即時反映する
- マーケットメイクや裁定で価格変化に反応する
- API polling を減らして rate limit 消費を抑える
再接続設計が本体
公式 Docs は、自動化されたユーザーは server side disconnect を処理し、gracefully reconnect すべきだと明記している。API server からの切断は予告なく定期的に起こり得るためである。欠損分は reconnect 時の snapshot ack や対応する info request で補完する設計が必要になる(出典: Hyperliquid Docs - Websocket)。
実務では、次のような構成が安定しやすい。
- WebSocket で差分イベントを受ける
- 定期的に
infoendpoint で snapshot を取り、内部状態と照合する - 切断時は再接続し、直近 timestamp / sequence / order id をもとに欠損を補完する
- 取引操作は idempotency を意識し、
cloidや内部注文 ID で重複を防ぐ
WebSocket を「つながっている間だけ便利なリアルタイム API」と考えると事故る。切れても復元できる状態機械として設計するのが本質である。
5. HyperEVM JSON-RPC の使いどころと制約
HyperEVM JSON-RPC は、Hyperliquid の EVM 互換レイヤーに接続するための RPC である。
使いどころ:
- HyperEVM 上のコントラクト状態を読む
- HyperEVM dApp のフロントエンドを作る
- HYPE を gas token とするトランザクションを送る
- HyperCore と HyperEVM をまたぐ dApp を設計する
- イベントログを index してダッシュボードを作る
ただし、default RPC の制約は理解しておく必要がある。
| 論点 | 公式 Docs 上の制約 | 実務上の意味 |
|---|---|---|
| historical state | default RPC では historical state を要求する request は未対応 | 過去時点の残高・storage を都度 RPC で読む設計は弱い |
eth_getLogs |
最大 4 topics、最大 50 blocks range | 長期間のログ収集は indexer 前提 |
eth_call / eth_getBalance など |
latest block のみ対応のメソッドがある | 一般的な archive RPC と同じ感覚では使えない |
| WebSocket JSON-RPC | 公式 RPC では現時点で未対応 | リアルタイム EVM イベントは別実装・外部RPC・自前 indexer を検討 |
したがって、HyperEVM dApp で「画面表示だけ」なら公式 RPC でも始めやすい。一方で、分析、監査、長期履歴、ユーザー別損益、コントラクトイベントの完全追跡を行うなら、早い段階で indexer 設計が必要になる。
6. 履歴データは公式 S3 だけで足りるか
Hyperliquid 公式は履歴データの入口として S3 bucket を案内している。
公式 Docs によると、hyperliquid-archive bucket には historical data が概ね月1回アップロードされるが、timely update の保証はなく、データ欠損の可能性もある。L2 book snapshots は market_data、asset contexts は asset_ctxs で提供される一方、candles や spot asset data など他の履歴データセットは S3 では提供されず、必要なら API で自分で記録する必要がある(出典: Hyperliquid Docs - Historical data)。
また、公式 Docs は hl-mainnet-node-data bucket に node fills、historical explorer blocks、L1 transactions などがあることも説明している(出典: Hyperliquid Docs - Historical data)。
公式 S3 が向く用途
- 過去の L2 book snapshot を使った市場構造分析
- 特定日・特定銘柄の板厚検証
- 自社収集データとの欠損補完
- 研究・検証・バックテストの初期データ
公式 S3 だけでは弱い用途
- リアルタイム監視
- 日次で確実に更新される機関向けレポート
- ユーザー別損益・約定履歴の完全再構築
- 1分足・秒足・spot data を含む網羅的な時系列分析
- SLA を伴う商用データ提供
事業者向けの現実解は、公式 S3 を基礎データとして見つつ、自社で必要なリアルタイムデータを継続収集することだ。特に取引・レポーティング・リスク管理に使うデータは、「後から公式 API で取ればよい」ではなく、最初から保存する前提で設計した方がよい。
7. 用途別の推奨アーキテクチャ
A. 取引フロントエンド
最小構成:
- HyperCore
infoendpoint - HyperCore
exchangeendpoint - WebSocket
- ユーザー別状態キャッシュ
- 署名・nonce・cloid 管理
ポイント:
- WebSocket だけに依存せず、snapshot で補正する
- 注文送信後の状態を
orderStatusと user events で照合する - UI 表示と実際の内部状態を分ける
- API エラー・rejected status をユーザーに説明できる形へ変換する
B. 分析ダッシュボード
最小構成:
- WebSocket stream collector
-
infoendpoint polling - 時系列 DB または OLAP DB
- 公式 S3 取り込み batch
- 銘柄・timestamp 正規化
ポイント:
- candle snapshot だけに頼らず、必要な粒度で自社集計する
- L2 book は保存コストが大きいので、集計粒度を先に決める
- 欠損検知と backfill job を用意する
- API response schema の変更に備えた versioning を行う
C. マーケットメイク / 裁定
最小構成:
- 低レイテンシ WebSocket
- 内部 orderbook
- 注文管理システム
- risk engine
- kill switch
- 複数 endpoint / 外部 provider / 自前 node の検討
ポイント:
- 価格取得より注文状態復元の方が難しい
- 切断時に「すべてキャンセル」か「状態復元して継続」かを事前に決める
- open interest cap、oracle rejection、post-only rejection など取引所固有の rejected reason を扱う
- latency 最適化より先に、重複注文と孤児注文を防ぐ
D. 機関向け接続・レポーティング
最小構成:
- 公式 API + WebSocket collector
- 監査ログ DB
- 履歴データ lake
- 外部データ provider または自社 indexer
- 権限分離された API wallet / subaccount 運用
- レポート生成 batch
ポイント:
- 「画面上の残高」と「監査上の証跡」を分けて保存する
- 署名者、操作権限、出金権限を分離する
- API 障害時のレポート欠損を明示できる設計にする
- データ provider を使う場合も、最終的な責任境界を契約・SLA で確認する
E. HyperEVM dApp
最小構成:
- HyperEVM JSON-RPC
- event indexer
- HyperCore API 連携
- HYPE gas / native transfer 設計
ポイント:
- default RPC の historical state 制約を前提にする
-
eth_getLogsの range 制限を考慮して小刻みに index する - HyperCore 側の資産・ポジションと EVM 側のコントラクト状態を混同しない
- コントラクト UI と取引 UI を同じデータモデルで扱わない
8. 外部 RPC・データプロバイダーを使う判断軸
外部 RPC やデータプロバイダーは、単に「速いから使う」ものではない。導入判断は、コスト、SLA、履歴範囲、対応 API、障害時の責任、データ再現性で見るべきである。
外部プロバイダーが有効なケース
- 公式 API 制限内では商用 traffic をさばけない
- WebSocket 接続の安定性や地理的レイテンシが重要
- HyperEVM の archive / debug / trace 相当が必要
- 長期の約定・板・account data をすぐ使いたい
- 自社で collector / indexer を運用する人員が足りない
- 顧客向け SLA を出す必要がある
自前収集を残すべきケース
- 約定・注文・ポジションが会計・監査に関わる
- 取引アルゴリズムの検証に完全な内部ログが必要
- provider 変更時にデータの連続性を失いたくない
- 重要な意思決定を外部 API のみで行いたくない
現実的には、外部プロバイダーを使っても、自社の最小監査ログは持つのがよい。外部 provider は可用性と開発速度を買うためのものだが、自社の注文・約定・判断根拠まで丸ごと外部に委ねると、障害時や顧客説明時に詰まる。
9. 実装時のリスクとチェックリスト
API / WebSocket
- Rate limit を user / IP / endpoint のどの単位で受けるか確認したか
- polling で取るデータと WebSocket で取るデータを分けたか
- WebSocket disconnect を前提に再接続・欠損補完を実装したか
-
cloidなどで重複注文を防げるか - order status の rejected reason を保存しているか
- API schema 変更に備えて parser を疎結合にしているか
データ基盤
- timestamp の基準を統一しているか
- asset ID / spot pair / perp coin name のマッピングを保存しているか
- raw response を一定期間保存しているか
- 集計値だけでなく再集計可能な元データを残しているか
- S3 公式データと自社収集データの差分検知ができるか
- 欠損時に backfill できるか
セキュリティ / 運用
- API wallet、master account、vault / subaccount の権限を分けているか
- 秘密鍵をアプリケーションサーバーに平文配置していないか
- 出金権限と注文権限を分離しているか
- kill switch と emergency cancel の運用手順があるか
- provider 障害時の fallback endpoint があるか
- 顧客向け表示に「データ遅延」「取得不能」を明示できるか
10. まとめ
Hyperliquid の API・RPC・データ基盤は、用途によって見るべきレイヤーが変わる。
- Perps の板・注文・ポジションは HyperCore
- リアルタイム更新は WebSocket
- EVM dApp は HyperEVM JSON-RPC
- 長期分析・監査・レポートは 公式 S3 + 自社収集 + indexer
検索上は「Hyperliquid RPC」「Hyperliquid API」「データプロバイダー」と一括りにされがちだが、実装上はまったく別の論点である。
事業者が最初に決めるべきなのは、どの provider を使うかではない。次の3点である。
- 何をリアルタイムで必要とするか
- 何を監査可能な形で保存するか
- どの障害までは自社で責任を持つか
この3点が決まると、公式 API だけで足りるのか、外部 RPC が必要なのか、自社 indexer を持つべきなのかが見える。
Hyperliquid は高性能な取引インフラだが、その上に商用プロダクトを作る場合は、取引 UX ではなく データ復元性・署名運用・履歴保存・障害時の説明責任 が設計の中心になる。
参考資料
- Hyperliquid Docs - Info endpoint
- Hyperliquid Docs - Exchange endpoint
- Hyperliquid Docs - Websocket
- Hyperliquid Docs - HyperEVM
- Hyperliquid Docs - JSON-RPC
- Hyperliquid Docs - Historical data
本記事は技術解説であり、投資・税務・法務助言ではありません。